نویسنده این یادداشت: آرش غازی
پردازش زبان طبیعی در آموزش زمانی ارزش عملی پیدا میکند که پاسخ یادگیرنده را به یک اقدام آموزشی مناسب تبدیل کند: تشخیص یک سوءبرداشت احتمالی، انتخاب تمرین مرتبط، ارائه راهنمایی مرحلهای و رساندن موارد مبهم به مدرس. اضافهکردن یک پنجره گفتوگو به سامانه آموزشی، بهتنهایی چنین قابلیتی ایجاد نمیکند. مسئله اصلی این است که نرمافزار بداند چه چیزی را باید بسنجد، بر اساس چه محتوایی بازخورد بدهد و در چه موقعیتی از تصمیم خودکار صرفنظر کند.
این یادداشت برای مدیران آموزشگاهها، طراحان محصولات آموزشی و تیمهای توسعه نوشته شده است. تمرکز آن، طراحی بازخورد شخصیسازیشده برای پاسخهای متنی است؛ نه ادعای جایگزینی معلم یا تضمین افزایش نمره. مثالها پیشنهادی و فرضیاند و نتیجه یک آزمایش اجراشده معرفی نمیشوند. برای نگاه عمومیتر به این حوزه، مطلب مزایای هوش مصنوعی در آموزش را بخوانید.
پیشینه پژوهشی این موضوع
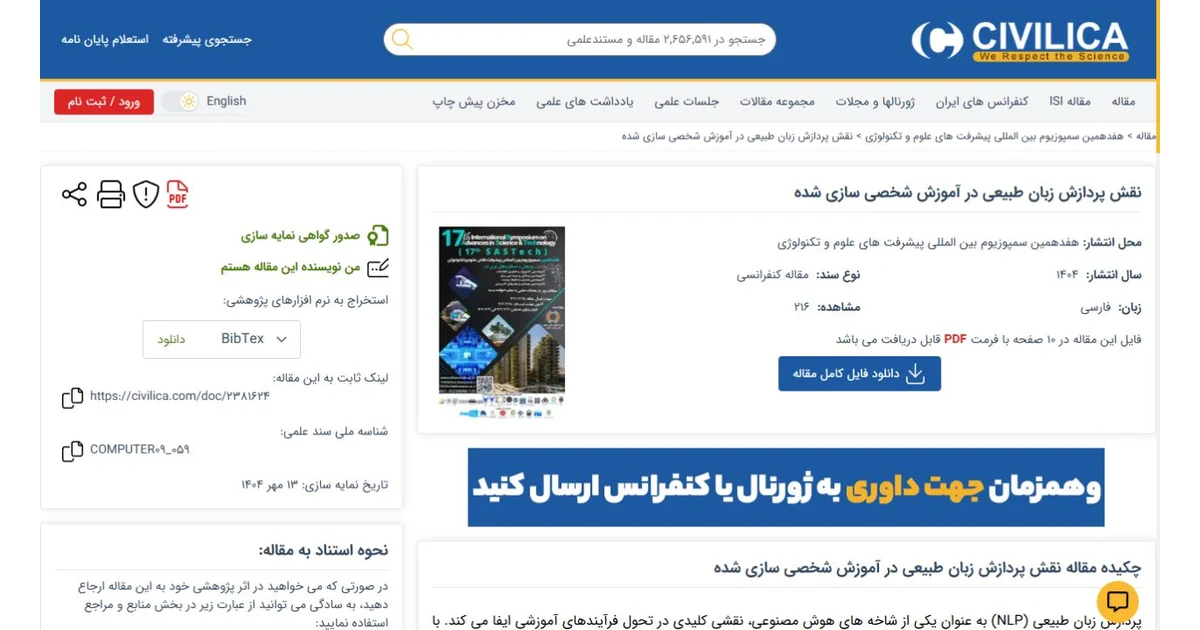
من به همراه الهام مهدیپور، نویسنده مقاله «نقش پردازش زبان طبیعی در آموزش شخصیسازیشده» هستم که در مجموعه هفدهمین سمپوزیوم بینالمللی پیشرفتهای علوم و تکنولوژی، سال ۱۴۰۴، منتشر و در سیویلیکا نمایه شده است. مشخصات این اثر ۱۰ صفحهای، با شناسه ملی COMPUTER09_059، در صفحه اصلی مقاله در سیویلیکا قابل بررسی است.
این نوشته، یادداشت تازهای درباره طراحی محصول آموزشی است و بازنشر متن آن مقاله کنفرانسی نیست. ارجاع به اثر قبلی، سابقه پرداختن به موضوع را نشان میدهد؛ مثالهای اجرایی این صفحه باید در محیط آموزشی خودشان ارزیابی شوند.
مشاهده تصویر بخش نویسندگان در سیویلیکا؛ آرش غازی و الهام مهدیپور
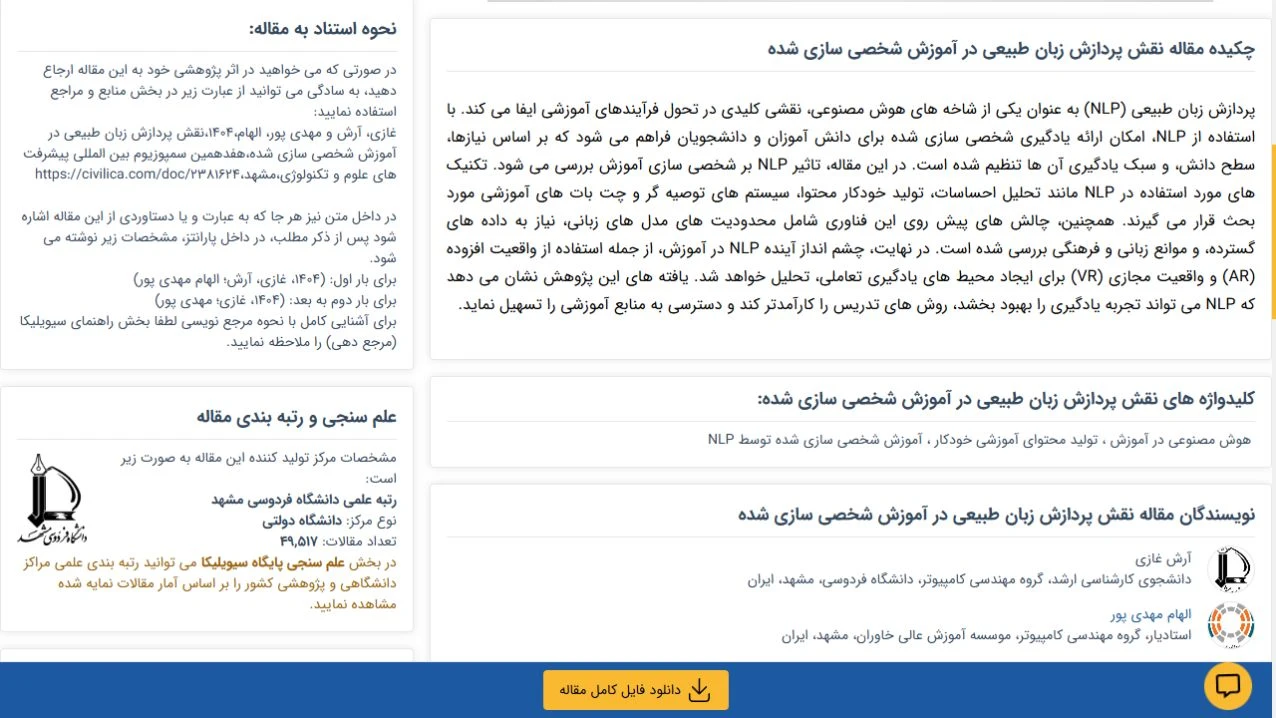
تصویر شاخص بالای این یادداشت از صفحه واقعی مقاله در سیویلیکا گرفته شده است. تصویر بخش نام نویسندگان نیز از لینک بالا قابل مشاهده است؛ هر دو ثبتشده در ۱۷ شهریور ۱۴۰۵. برای مشاهده مشخصات بهروز، لینک منبع را باز کنید.
شخصیسازی باید از هدف آموزشی شروع شود
فرض کنیم دو دانشجو به یک پرسش درباره کلید اصلی و کلید خارجی پایگاه داده پاسخ اشتباه دادهاند. ممکن است دانشجوی اول مفهوم یکتایی را نفهمیده باشد و دانشجوی دوم، ارتباط میان جدولها را اشتباه توضیح داده باشد. یک پیام ثابت با مضمون «پاسخ نادرست است» برای هیچکدام کافی نیست. در مقابل، یک سامانه مناسب باید شواهد موجود در پاسخ را بررسی کند و برای هر مسئله، راهنمایی مرتبطی پیشنهاد دهد.
پیش از انتخاب مدل، مدرس باید هدف درس و معیار پاسخ قابلقبول را تعریف کند. مثلاً انتظار داریم یادگیرنده بتواند نقش هر کلید را توضیح دهد، یک نمونه معتبر ارائه کند و تفاوت آنها را در یک سناریوی تازه به کار ببرد. این معیارها از برچسبهای کلی مثل «ضعیف» و «قوی» دقیقترند. نرمافزار نیز نباید از یک پاسخ کوتاه، درباره توانایی کلی یا شخصیت فرد نتیجهگیری کند.
شخصیسازی در این رویکرد یعنی تنظیم کمک بر اساس شواهد همان تکلیف و سابقه مرتبط؛ نه ساختن یک تصویر قطعی از فرد. اگر داده کافی نیست، خروجی درست میتواند یک سؤال روشنکننده باشد. گاهی پرسیدن «منظورت از ارتباط دو جدول چیست؟» از تولید یک توضیح طولانی و نامرتبط مفیدتر است.
چرخه پیشنهادی بازخورد با NLP
۱. دریافت پاسخ همراه با زمینه
پاسخ متنی بدون صورت سؤال، هدف درس و معیار ارزیابی ممکن است اشتباه تفسیر شود. ورودی سامانه بهتر است شامل همین موارد و بخش مجاز محتوای آموزشی باشد. لازم نیست نام، شماره تماس یا اطلاعات شخصی یادگیرنده در درخواست مدل قرار بگیرد. یک شناسه داخلی برای پیگیری روند آموزشی کافی است، مگر آنکه کاربرد مشخصی به داده دیگری نیاز داشته باشد.
برای فارسی، شکلهای مختلف «ی» و «ک»، نیمفاصله، غلط تایپی و ترکیب اصطلاحات انگلیسی را باید در آزمونها در نظر گرفت. پیشپردازش نیز نباید معنای جمله را تغییر دهد؛ حذف واژه «نیست» میتواند یک پاسخ درست را به ادعای نادرست تبدیل کند. متن اصلی را در کنار نسخه پردازششده نگه دارید تا مدرس بتواند تفسیر سامانه را بررسی کند.
۲. استخراج شواهد، نه فقط تولید نمره
بهجای درخواست یک نمره کلی، خروجی ساختاریافته بخواهید: کدام معیار پاسخ داده شده، چه شاهدی در متن وجود دارد، کدام بخش مبهم است و کدام سؤال تکمیلی لازم است. برای مثال، سامانه میتواند جملهای از پاسخ را به معیار «توضیح یکتایی» مرتبط کند، اما در نبود توضیح درباره ارتباط جدولها، آن قسمت را نامشخص بگذارد.
این ساختار به تیم کمک میکند خطا را پیدا کند. اگر سامانه شواهدی را گزارش کرده که اصلاً در پاسخ نیست، مشکل پیش از نمایش به کاربر قابل شناسایی است. درصد اطمینانی که مدل درباره خودش اعلام میکند نیز نباید بدون ارزیابی، معیار قطعی تصمیم باشد. سطح اتکاپذیری باید با پاسخهای واقعی و داوری مدرس سنجیده شود.
۳. بازیابی محتوای تأییدشده
منبع بازخورد باید معلوم باشد: فصل مشخصی از درس، یک مثال تأییدشده یا راهنمای حل تمرین. در سامانهای که از بازیابی محتوا استفاده میکند، مدل ابتدا بخش مرتبط را دریافت میکند و سپس بر پایه آن راهنمایی میسازد. با این حال، وجود منبع بهتنهایی صحت پاسخ را تضمین نمیکند؛ انتخاب منبع اشتباه یا برداشت نادرست از متن همچنان ممکن است.
هر پاسخ آموزشی بهتر است به بخش استفادهشده از محتوا پیوند داشته باشد. مدرس باید بتواند نسخه منبع و تاریخ تغییر آن را ببیند. وقتی جزوه اصلاح میشود، بازخوردهای تولیدشده بر اساس نسخه قدیمی نیز قابل شناسایی باشند. این قابلیت برای درسهایی که تعاریف یا رویههایشان تغییر میکند، از ظاهر جذاب گفتوگو مهمتر است.
۴. ارائه کمک مرحلهای
هدف بازخورد، تمامکردن تکلیف به جای یادگیرنده نیست. یک الگوی پیشنهادی این است که ابتدا اشاره کوتاه داده شود، سپس در صورت درخواست، یک مثال مشابه نمایش داده شود و بعد سؤال سادهتری برای بررسی فهم مطرح شود. پاسخ نهایی تنها در موقعیتی ارائه شود که سیاست آموزشی اجازه میدهد.
در مثال پایگاه داده، سامانه میتواند ابتدا بپرسد: «اگر دو دانشجو نام یکسان داشته باشند، چه چیزی باید آنها را از هم متمایز کند؟» این سؤال توجه را به مفهوم یکتایی برمیگرداند. سپس میتوان یک مثال مستقل از سؤال اصلی آورد. میزان کمک باید ثبت شود؛ حل درست پس از دریافت پاسخ کامل، با حل مستقل یک مسئله تازه یکسان نیست.
۵. ارجاع موارد مبهم به مدرس
پاسخهای متناقض، اعتراض به ارزیابی، نبود منبع مناسب یا اختلاف میان معیارها باید مسیر انسانی داشته باشند. ارجاع به مدرس شکست سامانه نیست؛ بخشی از طراحی مسئولانه آن است. در داشبورد، مدرس بهتر است پاسخ اصلی، معیار مورد اختلاف و پیشنهاد سامانه را کنار هم ببیند تا مجبور به بازسازی کل گفتوگو نشود.
برای تصمیمهای مهم مانند نمره نهایی، مردودی یا محرومیت آموزشی، این یادداشت اتکای صرف به خروجی مدل را پیشنهاد نمیکند. نقش مناسب نسخه اولیه، کمک به بازخورد تکوینی و تمرین است؛ جایی که خطا قابل اصلاح و تصمیم قابل بازبینی باشد.
یک سناریوی اجرایی برای آموزشگاه
فرض کنید آموزشگاهی میخواهد تمرینهای متنی یک فصل مشخص را پشتیبانی کند. شروع مناسب، اتصال همه درسها به یک مدل عمومی نیست. ابتدا مدرس چند هدف محدود انتخاب میکند، پاسخهای نمونه را با معیار روشن بررسی میکند و مجموعهای از اشتباهات رایج همان درس را مینویسد. سپس تیم توسعه، دریافت پاسخ و نمایش پیشنهاد را در محیط آزمایشی پیاده میکند.
در مرحله نخست، پیشنهادهای مدل فقط به مدرس نمایش داده میشوند. مدرس مشخص میکند کدام بازخورد درست، ناقص، بیشازحد راهنما یا گمراهکننده بوده است. پس از اصلاح، میتوان نمایش برخی راهنماییهای کمخطر را برای یک گروه محدود فعال کرد. این ترتیب، فرصتی برای شناخت خطاها پیش از گسترش استفاده فراهم میکند.
برای مثال، یک یادگیرنده ممکن است اصطلاح علمی را با واژههای ساده توضیح دهد و پاسخ او درست باشد. اگر سامانه صرفاً به تطابق کلمات حساس باشد، این پاسخ را نادیده میگیرد. نمونه دیگری ممکن است واژههای درست را کنار هم گذاشته باشد، ولی رابطه مفهومی اشتباه باشد. مجموعه آزمون باید هر دو وضعیت را پوشش دهد؛ وگرنه امتیاز ظاهراً خوب مدل، ضعف آموزشی آن را پنهان میکند.
موفقیت را با کیفیت یادگیری بسنجیم
تعداد پیامها، طول گفتوگو و سرعت تولید پاسخ، بهتنهایی معیار موفقیت آموزشی نیستند. پیش از پایلوت، معیارهای ارزیابی را تعیین کنید: درستی بازخورد به تشخیص مدرس، میزان راهنمایی بیشازحد، تعداد موارد ارجاع، زمان لازم برای بازبینی و توانایی حل یک تمرین تازه بدون کمک. ثبت این شاخصها امکان مقایسه نسخههای مختلف سامانه را فراهم میکند.
برای بررسی اثر بر یادگیری، میتوان یک پیشآزمون و پسآزمون همسطح و یک تکلیف انتقالی طراحی کرد. اگر گروه مقایسه دارید، زمان آموزش، محتوا و شرایط اجرا باید تا حد ممکن مشابه باشد. بهبود مشاهدهشده را بدون چنین کنترلهایی نباید با قطعیت به هوش مصنوعی نسبت داد. رضایت کاربر نیز ارزشمند است، اما با یادگیری عمیق یکی نیست.
ارزیابی را برای پاسخهای کوتاه، بلند، محاورهای و دارای غلط تایپی جداگانه مرور کنید. یک مدل ممکن است با نثر رسمی خوب کار کند و در برابر پاسخ درست اما نامنظم ضعیف باشد. معیار پذیرش باید پیش از مشاهده نتایج تعیین شود، نه اینکه بعداً با نتایج موجود تطبیق داده شود.
حریم خصوصی و اختیار یادگیرنده
راهنمای یونسکو درباره هوش مصنوعی مولد در آموزش و پژوهش بر رویکرد انسانمحور، حفاظت از داده و ارزیابی تناسب ابزارها تأکید دارد. این جهتگیری برای طراحی محصول آموزشی مهم است؛ مسئولیت آموزشی نباید صرفاً به دلیل در دسترس بودن یک مدل به آن سپرده شود.
پیشنهاد اجرایی این یادداشت، جمعآوری حداقل داده لازم، تعیین مدت نگهداری و روشنکردن دسترسیهاست. مدرس باید فقط اطلاعات موردنیاز کلاس خود را ببیند. ارسال پاسخها به ارائهدهنده بیرونی باید با سیاست مؤسسه و شرایط سرویس سازگار باشد. از اطلاعات حساس یا هویتی در نمونههای آزمایشی استفاده نکنید و امکان اصلاح سوابق اشتباه را پیشبینی کنید.
تحلیل متن را به تشخیص قطعی احساس، اختلال یا وضعیت روانی تبدیل نکنید. جمله «این درس سخت است» میتواند درخواست کمک، شوخی یا واکنش لحظهای باشد. طراحی بهتر، پیشنهاد کمک اختیاری است، نه برچسبگذاری پنهان. کاربر همچنین باید بداند بازخورد با کمک سامانه خودکار ساخته شده و چگونه میتواند آن را به مدرس ارجاع دهد.
از نمونه اولیه تا نرمافزار قابلاتکا
برای اجرای عملی، علاوه بر مدل به مدیریت کاربران، مخزن محتوای نسخهدار، ثبت بازخورد مدرس و کنترل هزینه نیاز دارید. قطع ارتباط با سرویس مدل نباید پاسخ دانشجو را از بین ببرد. سامانه میتواند تکلیف را ذخیره کند و وضعیت «در انتظار بررسی» نشان دهد. محدودیت طول پاسخ، تعداد درخواست و زمان انتظار نیز باید متناسب با تجربه آموزشی تعیین شود.
تیمهای آموزش میتوانند از خدمات طراحی راهکارهای هوش مصنوعی ایزیساز برای بررسی امکانپذیری استفاده کنند. اگر این چرخه باید به سامانه آموزشی، گزارشها و دسترسیهای اختصاصی متصل شود، موضوع در حوزه توسعه نرمافزار سفارشی قرار میگیرد. انتخاب فناوری بهتر است پس از تعریف مسئله، داده و معیار پذیرش انجام شود.
جمعبندی و قدم بعدی
کاربرد مؤثر NLP در آموزش شخصیسازیشده، از تعریف هدف و معیار شروع میشود و به بازخورد قابلبررسی، تمرین مناسب و امکان مداخله مدرس میرسد. ارزش اصلی، تولید متن بیشتر نیست؛ کمک دقیقتر در زمان مناسب است. یک پایلوت محدود و سنجشپذیر، اطلاعات بهتری برای تصمیمگیری میدهد تا راهاندازی سریع یک دستیار عمومی برای همه درسها.
اگر قصد ساخت چنین محصولی دارید، یک درس، چند نمونه پاسخ بینام و معیار ارزیابی مدرس را آماده کنید و از طریق درخواست بررسی پروژه آموزشی با ایزیساز در میان بگذارید. خروجی اولین گفتوگو باید محدوده روشن آزمایش و معیار موفقیت باشد، نه وعده نتیجهای که هنوز اندازهگیری نشده است.
مشخصات پژوهش مرتبط
غازی، آرش و مهدیپور، الهام. ۱۴۰۴. «نقش پردازش زبان طبیعی در آموزش شخصیسازیشده». هفدهمین سمپوزیوم بینالمللی پیشرفتهای علوم و تکنولوژی، مشهد. شناسه COMPUTER09_059. مشاهده رکورد و مسیر دریافت مقاله در سیویلیکا.