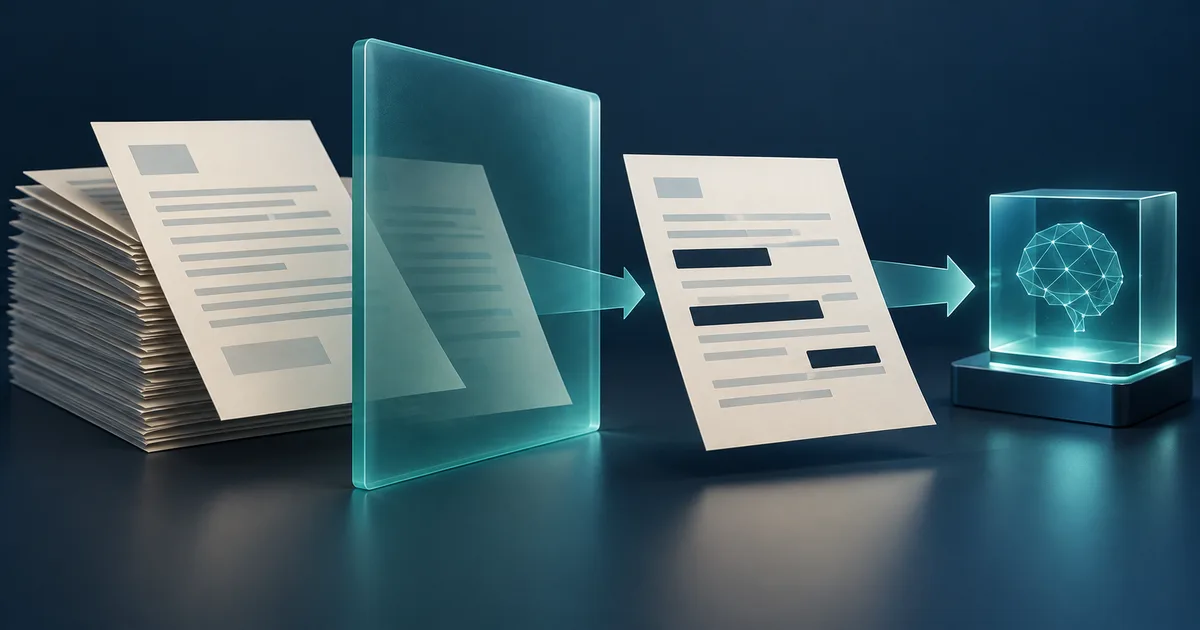
حذف اطلاعات حساس پیش از ارسال به هوش مصنوعی یعنی فقط دادهای از مرز پردازش خارج شود که برای انجام همان کار لازم و مجاز است. اگر هدف، دستهبندی یک درخواست پشتیبانی باشد، معمولاً نام کامل مشتری یا شماره تماس او کمکی به تشخیص موضوع نمیکند. راه درست این نیست که همه متن را ارسال کنیم و از مدل بخواهیم محرمانه نگهش دارد؛ باید قبل از ارسال، ورودی را محدود و بخشهای غیرضروری را حذف یا جایگزین کنیم.
این راهنما برای مدیر محصول، صاحب فرایند و تیم فنی نوشته شده است که میخواهند یک قابلیت هوش مصنوعی را به نرمافزار سازمانی متصل کنند. تمرکز بر آمادهسازی ورودی و کنترل مسیر خروج داده است؛ نه ارائه تضمین امنیت کامل یا تفسیر الزامات قانونی. نوع داده، مقصد پردازش و مجوزهای سازمان باید برای هر کاربرد جداگانه بررسی شوند.
ابتدا مشخص کنید مدل واقعاً چه کاری انجام میدهد
جمله کلی «مدل باید پرونده را بخواند» برای تصمیمگیری کافی نیست. آیا قرار است موضوع پیام را تشخیص دهد، خلاصه عملیاتی بنویسد یا اطلاعات مشخصی استخراج کند؟ برای هر خروجی، حداقل ورودی مورد نیاز را تعریف کنید. هرچه وظیفه مبهمتر باشد، احتمال ارسال بیدلیل کل پرونده، تاریخچه گفتگو و پیوستهای اضافی بیشتر میشود.
فرض کنید نرمافزار باید تیکتها را به واحد مناسب ارجاع دهد. متن خطا و نام قابلیت درگیر ممکن است ضروری باشند، اما نشانی منزل فرستنده یا امضای کامل ایمیل ضرورتی ندارد. در مقابل، اگر تشخیص مسئله به نوع دستگاه وابسته باشد، حذف نوع دستگاه کیفیت نتیجه را خراب میکند. هدف، کمینهسازی آگاهانه است؛ نه حذف کورکورانه هر چیزی که شبیه عدد یا اسم به نظر میرسد.
برای شروع، یک برگه ساده با سه ستون ذهنی تهیه کنید: اطلاعات ضروری، اطلاعات قابل جایگزینی و اطلاعات ممنوع برای این مقصد. مالک فرایند باید آن را تأیید کند. این تصمیم را صرفاً به برنامهنویس یا تشخیص خودکار واگذار نکنید، چون حساسیت یک کد داخلی یا نام پروژه ممکن است فقط برای تیم کسبوکار روشن باشد.
حذف، پوشاندن و جایگزینی یک معنی ندارند
حذف یعنی بخش غیرضروری اصلاً در ورودی نهایی نباشد؛ مثلاً امضای ایمیل از متن تحلیل کنار گذاشته شود. پوشاندن یعنی مقدار اصلی با نشانهای عمومی جایگزین شود؛ مانند «شماره تماس حذف شد». جایگزینی پایدار در محدوده یک درخواست یعنی نام یک فرد در همه جای همان متن با برچسب یکسانی مثل «شخص الف» نمایش داده شود تا رابطه جملهها حفظ شود.
اگر سامانه جدول ارتباط میان برچسب و مقدار اصلی را نگه دارد، داده الزاماً ناشناس نشده است؛ امکان بازگردانی هنوز وجود دارد. آن جدول خودش یک دارایی حساس است و نباید همراه متن به مقصد خارجی فرستاده شود. مدت نگهداری، دسترسی و حذف آن باید مشخص باشد. استفاده از واژه «ناشناس» بدون توجه به این تفاوت، برداشت نادرستی از سطح حفاظت میسازد.
گاهی حتی پس از حذف نام، ترکیب سمت شغلی، محل، تاریخ و شرح یک اتفاق میتواند فرد را قابل شناسایی کند. بنابراین کنترل فقط به پیدا کردن ایمیل و شماره تلفن محدود نیست. اگر جزئیات برای انجام کار لازم نیستند، میتوان آنها را کلیتر کرد؛ مثلاً بهجای محل دقیق از ناحیه عمومی استفاده کرد. این تغییر نیز باید با نیاز واقعی خروجی سازگار باشد.
کنترل باید قبل از اولین ارسال انجام شود
اگر برای تشخیص اطلاعات حساس، متن خام را به همان سرویس بیرونی بفرستید، اطلاعات پیش از حذف از مرز مورد نظر خارج شده است. مسیر تشخیص و پاکسازی باید در محیطی اجرا شود که برای دریافت داده خام مجاز است. این محیط میتواند بخشی از زیرساخت داخلی یا یک سرویس تأییدشده با شرایط مشخص باشد؛ انتخاب آن به سیاست سازمان وابسته است.
همچنین فقط پیام اصلی کاربر را نبینید. تاریخچه گفتگو، متن بازیابیشده از اسناد، خروجی ابزارها، نام فایل و محتوای پیوست میتوانند به درخواست نهایی اضافه شوند. کنترل باید روی مجموعه واقعی دادهای باشد که ارسال میشود، نه نسخهای کوچکتر که در صفحه نمایش داده میشود. تفاوت میان «متن قابل مشاهده» و «درخواست واقعی» یکی از نقاط مهم بازبینی است.
این موضوع با انتخاب محل اجرای مدل ارتباط دارد، اما جایگزین آن نیست. در راهنمای استقرار خصوصی هوش مصنوعی درباره این تصمیم توضیح دادهایم. حتی در محیط خصوصی هم اصل ارسال حداقل داده و محدود کردن دسترسی کاربرد دارد؛ داخلی بودن یک سرویس به معنی مجاز بودن دسترسی همه اجزای آن به همه اطلاعات نیست.
سه لایه برای تشخیص دادههای حساس
قواعد مشخص برای قالبهای شناختهشده
برای دادههایی با قالب مشخص میتوان قواعد تشخیص تعریف کرد. اما یک رشته عددی همیشه شماره تماس نیست و یک شماره با فاصله یا ارقام فارسی ممکن است از یک قاعده ساده عبور کند. قالب، بافت جمله و استثناهای کاربرد باید با هم بررسی شوند. در نرمافزار فارسی، ترکیب حروف فارسی و عربی، نیمفاصله و شکلهای مختلف رقم را در نمونههای آزمون بگنجانید.
تشخیص وابسته به متن
نام افراد و نشانیها همیشه قالب ثابت ندارند. ابزارهای تشخیص موجودیت میتوانند بخشی از این کار را انجام دهند، ولی باید پوشش زبان و نوع داده آنها آزمایش شود. مستندات Presidio Analyzer نمونهای از چارچوب تحلیل موجودیتهای حساس را معرفی میکند. وجود یک ابزار آماده به معنی پوشش تضمینی متن فارسی یا اطلاعات اختصاصی سازمان شما نیست.
قواعد اختصاصی کسبوکار
نام مشتری تجاری، شماره قرارداد داخلی یا عنوان یک پروژه محرمانه ممکن است در فهرست عمومی ابزار نباشد. مالک داده باید این موارد را مشخص کند. فهرستها هم نیازمند بازبینی هستند؛ سازمان و نامگذاریها تغییر میکنند. بهتر است نسخه سیاست پاکسازی ثبت شود تا بعداً بتوان فهمید هر درخواست با چه قواعدی پردازش شده است.
تصویر، فایل و لاگ را فراموش نکنید
حذف متن از ورودی کافی نیست اگر تصویر همان صفحه همچنان نام و شماره را نشان دهد. سند ممکن است اطلاعات را در سربرگ، پاورقی، تصویر اسکنشده یا لایه متنی پنهان داشته باشد. قبل از استفاده از فایل واقعی، مشخص کنید کدام بخشها استخراج میشوند و نسخه ارسالی دقیقاً چه محتوایی دارد. سیاه کردن ظاهری بخشی از یک فایل، بدون حذف اطلاعات زیر آن، لزوماً پاکسازی واقعی نیست.
لاگها نیز مسیر دیگری برای نشت ناخواستهاند. اگر درخواست خام پیش از پاکسازی در گزارش خطا ذخیره شود، هدف کمینهسازی فقط در یک بخش اجرا شده است. برای پایش، معمولاً میتوان شناسه درخواست، نوع عمل، نسخه سیاست و تعداد موارد شناساییشده را ثبت کرد، بدون آنکه متن کامل لازم باشد. نیاز به نگهداری نمونه برای عیبیابی باید جداگانه و با دسترسی محدود تعریف شود.
نگهداری گفتگو و حافظه دستیار هم موضوع مستقلی است. راهنمای نگهداری حافظه دستیار هوش مصنوعی به این بخش میپردازد. پاکسازی ورودی امروز، مجوز ذخیره نامحدود خروجی یا جدول بازگردانی نیست؛ هر کدام باید قاعده و مسئول خود را داشته باشند.
مثال عملی: دستهبندی درخواست خدمات
یک پیام فرضی شامل نام مشتری، شماره تماس، نشانی و این توضیح است که دستگاه پس از بهروزرسانی روشن نمیشود. برای ارجاع پیام به واحد فنی، ممکن است شرح مشکل، مدل دستگاه و زمان نسبی شروع خطا کافی باشد. نسخه ارسالی میتواند مشخصات هویتی را حذف کند و در عین حال اطلاعات فنی لازم را نگه دارد. نتیجه مدل فقط یک دسته پیشنهادی است، نه اجازه دسترسی به پرونده کامل.
اگر در همان متن از دو دستگاه یا دو شخص نام برده شده باشد، همه آنها را با یک برچسب یکسان جایگزین نکنید. از بین رفتن تمایزها میتواند خلاصه را اشتباه کند. برچسبها باید فقط در محدوده لازم پایدار باشند و از خودشان هویت واقعی را آشکار نکنند. نمونه را طوری طراحی کنید که بتوانید هم میزان حذف داده غیرضروری و هم صحت ارجاع را بررسی کنید.
این مثال، گزارش نتیجه یک مشتری واقعی نیست. پیش از اجرا روی اطلاعات واقعی، با داده ساختگی و سپس نمونههای مجازِ کنترلشده آزمایش کنید. برای نشان دادن موفقیت سامانه، اطلاعات خصوصی را در تصویر گزارش یا فایل آزمایشی عمومی قرار ندهید؛ محیط آزمون نیز باید متناسب با حساسیت داده اداره شود.
اگر پاکسازی نامطمئن بود چه اتفاقی بیفتد؟
نباید هر خطای تشخیص به ارسال بیقید متن خام منجر شود. برای ورودیهای پرریسک، توقف ارسال و ارجاع به مسیر مجاز میتواند انتخاب مناسبی باشد. رابط کاربری باید توضیح دهد که پردازش انجام نشده و اقدام بعدی چیست، بدون آنکه بخش حساس را در پیام خطای عمومی تکرار کند. کاربر نباید برای ادامه کار مجبور شود حفاظت را دور بزند.
همه موارد هم نیازمند یک رفتار واحد نیستند. ورودی کمخطر با قالب شناختهشده، سند پیچیده و پیوست ناشناخته میتوانند مسیرهای متفاوت داشته باشند. این مسیرها باید از قبل تعریف شوند؛ تصمیم لحظهای و نامشخص اپراتور، قابل آزمون و پیگیری نیست. در هر حالت معلوم باشد چه کسی حق بازبینی دارد و چه دادهای برای او قابل مشاهده است.
کیفیت را از دو جهت بسنجید
یک خطا این است که داده حساس باقی بماند؛ خطای دیگر این است که اطلاعات مفید بیدلیل حذف شود و مدل نتواند کارش را انجام دهد. هر دو را با نمونههای برچسبخورده بسنجید. فقط گفتن اینکه «بیشتر شمارهها حذف شدند» کافی نیست. نوع داده، زبان، قالب سند و شدت اثر خطا باید در گزارش مشخص باشند.
آزمون باید درخواست نهایی خروجی را بررسی کند، نه صرفاً خروجی تابع پاکسازی. ممکن است مرحله بعد دوباره نام مشتری را از تاریخچه به متن اضافه کند. همچنین خطا، تلاش مجدد و مسیرهای جایگزین را آزمایش کنید. موفقیت یک درخواست معمولی ثابت نمیکند همه مسیرهای ارسال از کنترل عبور میکنند.
معیار پذیرش را با مالک داده تعیین کنید و برای مواردی که هنوز پوشش قابل اتکا ندارند محدودیت روشن بگذارید. عدد دقت کلی بدون توضیح مجموعه آزمون گمراهکننده است. با تغییر مدل تشخیص، قواعد یا قالب اسناد، آزمونها را دوباره اجرا کنید؛ نسخه تازه الزاماً در همه انواع ورودی بهتر نیست.
جمعبندی: کمینهسازی را بخشی از طراحی محصول کنید
برای استفاده مسئولانه از هوش مصنوعی، ابتدا وظیفه را محدود کنید، داده لازم را تعیین کنید و پیش از خروج اطلاعات، کنترل قابل آزمون قرار دهید. حذف دادههای غیرضروری، جایگزینی درست، کنترل پیوست و لاگ، و رفتار مشخص هنگام خطا باید کنار هم دیده شوند. هیچکدام بهتنهایی تضمین حذف همه ریسکها نیستند.
برای بررسی یک کاربرد مشخص میتوانید از خدمات هوش مصنوعی ایزیساز شروع کنید. بهتر است در مرحله اول نمونه ساختگی از ورودی، خروجی مورد انتظار و فهرست اطلاعات ممنوع را ارائه کنید. خروجی ارزیابی باید نقشه جریان داده و معیار پذیرش پاکسازی باشد، نه صرفاً افزودن یک عبارت «اطلاعات محرمانه است» به دستور مدل.