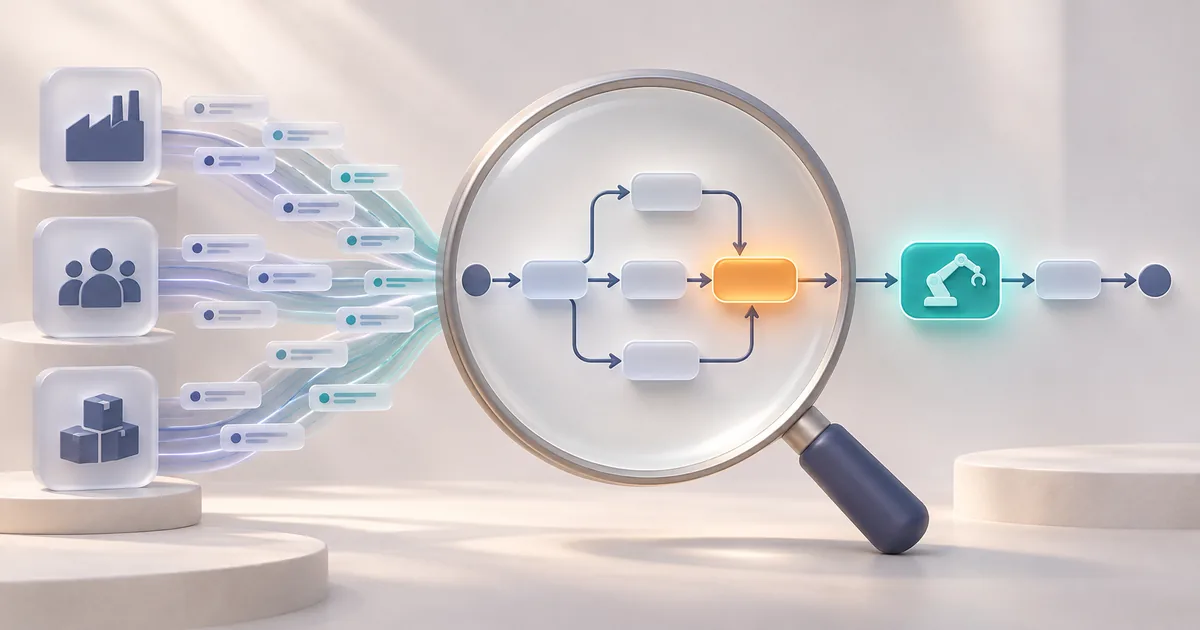
اگر میخواهید یک فرایند را با هوش مصنوعی خودکار کنید، ابتدا باید بدانید کار در عمل چگونه پیش میرود؛ نه اینکه فقط نمودار مصوب آن چه میگوید. فرایندکاوی با کنار هم گذاشتن رویدادهای ثبتشده در سامانهها، مسیرهای واقعی پروندهها را نشان میدهد: کجا منتظر میمانند، چند بار بازمیگردند و کدام استثناها تکرار میشوند. این تصویر، نقطهٔ شروع انتخاب یک اتوماسیون ارزشمند است؛ خودِ آن جایگزین تحلیل کسبوکار یا تصمیم انسانی دربارهٔ اجرا نیست.
برای مدیر عملیاتی، پرسش اصلی این نیست که «آیا فرایندکاوی نرمافزار جذابی دارد؟» پرسش این است که آیا دادهٔ کافی برای تشخیص گلوگاه وجود دارد و آیا رفع آن گلوگاه به تجربهٔ مشتری، زمان تیم یا کیفیت خروجی کمک میکند. در این راهنما از انتخاب دامنه و آمادهسازی لاگ تا تصمیم دربارهٔ نقش هوش مصنوعی و پایلوت کمریسک پیش میرویم.
فرایندکاوی دقیقاً چه چیزی را آشکار میکند؟
در یک گردش کار معمول، هر درخواست از چند وضعیت میگذرد؛ مثلاً ثبت، بررسی مدارک، ارجاع، تأیید و انجام. هر بار تغییر وضعیت یک رویداد است. اگر رویدادها شناسهٔ مشترک پرونده، نام فعالیت و زمان معتبر داشته باشند، میتوان آنها را به مسیر هر پرونده وصل کرد. راهنمای رسمی Microsoft برای آمادهسازی دادهٔ فرایندکاوی همین سه مؤلفه را مبنای لاگ رویداد میداند؛ مستندات IBM نیز ساختار مشابهی را شرح میدهد.
خروجی مفید صرفاً یک نمودار پرخط نیست. باید بتوانید بپرسید کدام مسیرها بیشترین تعداد پرونده را دارند، کدام مرحله زمان انتظار میسازد و آیا بازگشت از «تأیید» به «تکمیل مدارک» استثنایی نادر است یا رفتار رایج. سپس مسیر مشاهدهشده را با قاعدهٔ مورد انتظار مقایسه کنید. ممکن است چیزی که «خطا» به نظر میآید، در واقع رویهٔ ضروری تیم برای جبران نقص سیستم باشد.
فرایندکاوی رفتار ثبتشده را میبیند، نه تمام واقعیت را. تماس تلفنی، پیام خارج از سامانه، تصمیم شفاهی یا کاری که اصلاً ثبت نشده باشد در نقشه ظاهر نمیشود. بنابراین مصاحبه با افراد اجراکننده و مشاهدهٔ چند پروندهٔ واقعی مکمل ضروری داده است. نتیجه را بهعنوان فرضیهٔ قابل بررسی ببینید، نه حکم قطعی دربارهٔ عملکرد اشخاص.
چرا قبل از اتوماسیون هوش مصنوعی به آن نیاز داریم؟
خودکار کردن یک مرحلهٔ نامناسب میتواند گلوگاه را فقط به جای دیگری منتقل کند. فرض کنید مدل، درخواستها را سریع طبقهبندی میکند اما تیم مقصد ظرفیت رسیدگی ندارد. زمان تصمیم مدل پایین میآید، ولی انتظار مشتری تغییر نمیکند. یا اگر مدارک ناقص در ابتدای کار پذیرفته میشوند، سرعت ارجاع خودکار صرفاً صف بازگشت را بزرگتر میکند.
فرایندکاوی کمک میکند مسئله را در سطح «پروندهٔ کامل از آغاز تا پایان» تعریف کنید. ابتدا زمان بین رویدادها را ببینید؛ بعد روشن کنید این فاصله زمان کار واقعی است یا انتظار. وقتی محل تکرار، تأخیر یا بازکاری مشخص شد، میتوان تصمیم گرفت راهحل از جنس اصلاح فرم، تغییر اختیار تأیید، اتصال دو سامانه، یک قانون ساده یا هوش مصنوعی است. انتخاب هوش مصنوعی فقط به دلیل مد روز بودن، هزینهٔ نگهداری و ریسک خطا را بیدلیل وارد فرایند میکند.
اگر هنوز نقشهٔ کلی گامهای تحول را میخواهید، مقالهٔ اجرای سایهٔ اتوماسیون پیش از فعالسازی دربارهٔ آزمون بیاثر جانبی پس از طراحی راهحل است. فرایندکاوی در این نوشته یک مرحله عقبتر قرار میگیرد: تشخیص اینکه اصلاً چه چیزی را باید تغییر داد.
از کدام فرایند شروع کنیم؟
یک فرایند محدود با شروع و پایان روشن برگزینید؛ مثلاً «از ثبت درخواست خدمت تا اعلام نتیجه» یا «از دریافت فاکتور تا ثبت قطعی». موضوعی که میان پنج سامانه، چند شرکت و دهها نوع پرونده پخش شده باشد، برای تجربهٔ نخست مناسب نیست. یک دامنهٔ کوچک، اختلاف تعریفها و کمبود داده را زودتر نشان میدهد.
در جلسهٔ شروع، مالک فرایند، مسئول داده و نمایندهٔ تیم اجرا را کنار هم بگذارید. هر کدام باید بتوانند به چهار پرسش پاسخ دهند: شناسهٔ پرونده چیست؟ پایان موفق کجاست؟ کدام وضعیتها از نظر کسبوکار متفاوتاند؟ چه دادهای را نباید در خروجی تحلیلی آشکار کرد؟ اگر روی تعریف «پرونده» توافق نیست، استخراج لاگ را آغاز نکنید؛ یک سفارش ممکن است چند پرداخت داشته باشد و یک مشتری چند سفارش. انتخاب شناسهٔ اشتباه، نقشهای ظاهراً دقیق اما گمراهکننده میسازد.
معیار انتخاب پایلوت را نیز از ابتدا بنویسید: حجم قابل مشاهده، تنوع مسیرها، اهمیت تأخیر و امکان مداخلهٔ واقعی. فرایندی که دادهٔ کامل دارد اما سازمان اختیار تغییر آن را ندارد، موضوع تحلیلی خوبی است ولی پایلوت اتوماسیون خوبی نیست. در مقابل، فرایندی با دادهٔ ناقص ممکن است ابتدا به اصلاح ثبت رویداد نیاز داشته باشد.
لاگ رویداد را چگونه آماده کنیم؟
حداقل برای هر رخداد، شناسهٔ پرونده، نام فعالیت و زمان رویداد لازم است. در برخی سامانهها زمان شروع و پایان جداگانه ثبت میشود و تحلیل زمان کار را دقیقتر میکند. اطلاعات اختیاری مانند واحد اجراکننده، نوع درخواست یا کانال ورود میتواند مقایسهٔ گروهها را ممکن کند؛ اما افزودن هر ستون باید هدف مشخص و مجوز دسترسی داشته باشد.
شناسه و زمان را پیش از تحلیل کنترل کنید
چند ردیف نمونه را دستی دنبال کنید. آیا تمام رویدادهای یک پرونده به یک شناسه وصلاند؟ آیا زمانها منطقهٔ زمانی یکسان دارند؟ آیا رویداد «انجام شد» پیش از «ثبت شد» رخ داده یا این تناقض از تبدیل تاریخ و ساعت آمده است؟ در سیستمهای چندگانه، اختلاف ساعت سرورها، رویدادهای تکراری و انتقال ناقص داده میتواند ترتیب فعالیتها را مخدوش کند. یک نقشهٔ فرایند بر پایهٔ چنین دادهای، حتی اگر زیبا باشد، مبنای تصمیم خرید نیست.
نامگذاری فعالیتها را هم یکدست کنید، ولی تفاوتهای واقعی را پاک نکنید. «بررسی اولیه»، «بررسی کارشناس» و «بازبینی پس از نقص» ممکن است سه فعالیت مختلف باشند. تجمیع زودهنگام آنها گلوگاه را پنهان میکند. برعکس، ده نام مختلف برای یک فعالیت واحد نقشه را شلوغ میکند. فرهنگ داده و مالک تعریف هر وضعیت باید مستند باشد.
حریم خصوصی و دسترسی را از ابتدا طراحی کنید
برای کشف مسیر، معمولاً به متن کامل مکاتبه یا شمارهٔ تماس مشتری نیاز نیست. شناسهٔ مستعار، نوع پرونده و رویدادهای لازم کافی است. دسترسی تحلیلگر را به دامنهٔ پایلوت محدود کنید و زمان نگهداری خروجی و روش حذف را مشخص کنید. اگر قرار است بعداً یک مدل هوش مصنوعی روی داده آموزش یا ارزیابی شود، این تصمیمی جدا از صرفِ استخراج لاگ است و باید جداگانه بررسی شود.
مثال عملی: درخواستهای خدمات سازمانی
فرض کنید یک شرکت درخواستهای خدمات مشتری را در پرتال ثبت میکند. تیم ابتدا تصور میکند تأخیر اصلی در تشخیص موضوع پیام است و میخواهد یک مدل دستهبندی بخرد. اما بررسی لاگ سه ماه اخیر نشان میدهد بیشتر پروندههای طولانی پس از ارجاع اول به مرحلهٔ «اطلاعات تکمیلی» برمیگردند. این مثال فرضی است؛ نسبت یا عددی دربارهٔ مشتریان ایزیساز ادعا نمیکند.
تیم پنج پروندهٔ بازگشتی را با مسئولان اجرا مرور میکند و درمییابد فرم اولیه نوع مدرک لازم را متناسب با درخواست نشان نمیدهد. اصلاح فرم و کنترل وجود مدرک، پیش از هر مدل هوش مصنوعی، مسئلهٔ اصلی را هدف میگیرد. برای درخواستهای آزاد و نامنظم، هوش مصنوعی شاید بتواند مدرک احتمالیِ جاافتاده را پیشنهاد کند، اما تصمیم نهایی و پیام به مشتری باید قاعده و مسئول روشن داشته باشد.
پس از اصلاح، همان شاخصها دوباره اندازهگیری میشوند: سهم پروندههای بازگشتی، زمان تا اولین رسیدگی، زمان انتظار برای مشتری و نرخ حل نهایی. هدف این نیست که صرفاً تعداد اقدامهای خودکار بالا برود. اگر تماسهای پیگیری بیشتر شده یا پروندهها بیدلیل بسته شدهاند، بهبود ادعایی قابل قبول نیست. نوشتهٔ پایش نتیجهٔ اتوماسیون در سامانهٔ مقصد توضیح میدهد چرا اجرای یک فرمان با تحقق نتیجه یکی نیست.
کجا هوش مصنوعی ارزش افزوده دارد و کجا ندارد؟
هوش مصنوعی زمانی ارزش بررسی دارد که ورودیها متنی یا تصویری و متنوعاند، تشخیص دستی پرهزینه است و خروجی را میتوان با شاهد و بازبینی سنجید. نمونهها شامل پیشنهاد دستهٔ درخواست، استخراج فیلد از سند یا تشخیص پروندهای است که احتمالاً به بازبینی نیاز دارد. حتی اینجا نیز مدل باید در یک محدودهٔ تعریفشده کار کند: آستانهٔ اطمینان، مسیر ارجاع، ثبت دلیل و امکان توقف.
اگر علت گلوگاه یک اختیار مبهم، صف بدون مسئول، فرم ناقص یا اتصال قطعشدهٔ دو سامانه است، مدل زبانی معمولاً درمان مسئله نیست. برای تصمیمهای قطعی و پایدار نیز یک قانون قابل فهم اغلب قابلاتکاتر و ارزانتر است. مقایسهٔ گزینهها را بر اساس هزینهٔ کل اجرا و نگهداری، خطای قابل تحمل، امکان توضیح تصمیم و اثر بر مشتری انجام دهید؛ نه فقط دقت یک آزمایش روی دادهٔ تمیز.
در همکاری با خدمات هوش مصنوعی ایزیساز، مسئله را بهصورت یک گلوگاه مستند مطرح کنید: مسیر فعلی، نمونهٔ دادهٔ مجاز، نتیجهٔ مطلوب و کاری که نباید خودکار شود. این ورودی برای تعیین دامنهٔ پایلوت مفیدتر از درخواست کلی «یک هوش مصنوعی برای همهٔ فرایندها» است.
از کشف فرایند تا پایلوت قابل سنجش
نتیجهٔ تحلیل را به فهرست بلندِ «فرصتهای هوش مصنوعی» تبدیل نکنید. دو یا سه فرضیهٔ محدود بنویسید؛ برای هرکدام مشخص کنید چه شاهدی از لاگ پشتیبان آن است، چه توضیح جایگزینی ممکن است، چه کسی میتواند تغییر را اجرا کند و شکست آن چه اثری دارد. سپس یک مورد با ریسک کنترلشده انتخاب کنید.
پیش از تغییر، خط مبنا را روی بازه و گروه پروندهٔ مشخص ثبت کنید. میانگین تنها کافی نیست؛ توزیع زمان و پروندههای بسیار کند را هم ببینید. دادهٔ قبل و بعد باید با تعریف یکسان جمعآوری شود. تغییر فصل، حجم ورودی یا سیاست پذیرش میتواند مقایسه را منحرف کند. اگر نمونه کم است، نتیجه را «نشانهٔ اولیه» بنامید، نه اثبات بازگشت سرمایه.
پایلوت را ابتدا در حالت مشاهده یا با تأیید انسانی اجرا کنید. خروجی پیشنهادی مدل، تصمیم واقعی کارشناس و نتیجهٔ نهایی را جدا ثبت کنید. معیار توقف داشته باشید: مثلاً افزایش بازگشت پرونده، ارجاع اشتباه به واحد حساس یا ناتوانی در توضیح نتیجه. بررسی هفتگی نمونههای خطا نشان میدهد باید مدل را اصلاح کرد، قاعده را تغییر داد یا اساساً از اتوماسیون صرفنظر کرد.
چه چیزی را در گزارش تصمیم بیاوریم؟
گزارش کوتاه باید دامنهٔ فرایند، کیفیت و محدودیت لاگ، مسیرهای اصلی، گلوگاه تأییدشده با تیم، گزینههای غیرهوشمصنوعی، فرضیهٔ مداخله، هزینههای پیادهسازی و معیار پذیرش را در کنار هم نشان دهد. نمودار بدون تعریف داده و محدودیت، برای تصمیم سرمایهگذاری کافی نیست. همچنین نام افراد را به رتبهبندی عملکرد تبدیل نکنید؛ هدف بهبود سیستم کار است، نه قضاوت فردی از روی لاگ ناقص.
جمعبندی و گام بعد
فرایندکاوی پیش از اتوماسیون با هوش مصنوعی کمک میکند بهجای سریعتر کردن یک مرحلهٔ دلخواه، مسئلهٔ واقعی را در کل مسیر پیدا کنید. با یک فرایند محدود، شناسه و زمان معتبر، گفتوگو با تیم اجرا و یک خط مبنای قابل تکرار شروع کنید. سپس راهحل سادهتر را کنار گزینهٔ هوش مصنوعی بگذارید و تنها موردی را آزمایش کنید که نتیجهاش قابل اندازهگیری و بازگشتپذیر است.
اگر برای انتخاب دامنه و طراحی پایلوت به بررسی مشترک نیاز دارید، شرح فرایند و نمونهٔ بدون دادهٔ حساس را برای ایزیساز بفرستید. پیشنهاد مناسب باید پس از شناخت محدودیت لاگ و مسئولیت تصمیم، نه پیش از آن، شکل بگیرد.